ana@sre: ~
whoami
¡Hola! Soy Ana Luiza
Site Reliability Engineer/DevOps Engineer | Carrera Internacional
cat sobre.txt
- He trabajado en Stone Pagamentos, Banco Iti e Itaú Unibanco — bancos, medios de pago y servicios financieros.
- Hoy trabajo en contratos internacionales en Estados Unidos.
- También hago mentoría de carrera internacional en tecnología.
- Y escribo sobre SRE, cloud y carrera.
# sobre mí
Sobre mí
Soy Site Reliability Engineer y me enfoco en la fiabilidad, la observabilidad y el rendimiento de sistemas en producción. He trabajado con plataformas de alto tráfico de cara al cliente, definiendo SLOs/SLIs, reduciendo el MTTR y construyendo observabilidad de punta a punta.
También creo contenido sobre carrera en SRE/DevOps y hago mentoría a profesionales que quieren crecer en el área, incluso de cara al mercado internacional.
# experiencia
Trayectoria profesional
marzo de 2025 – actualidad
Site Reliability Engineer
Contratos internacionales — Estados Unidos · Remoto
marzo de 2025 – actualidad
Site Reliability Engineer
Contratos internacionales — Estados Unidos · Remoto
- Despliegues en producción y automatización de despliegue canary con GitHub Actions.
- Implementación de herramientas de observabilidad.
- Desarrollo de soluciones de observabilidad con IA.
- Guardia on-call.
2024 – marzo de 2025
Site Reliability Engineer — nivel M
Itaú Unibanco · São Paulo, Brasil
2024 – marzo de 2025
Site Reliability Engineer — nivel M
Itaú Unibanco · São Paulo, Brasil
- Equipo de observabilidad de los canales principales de la app del banco — inicio de sesión, home y autenticación.
- Mapeo de las aplicaciones y de sus arquitecturas para poder actuar ante problemas e incidentes.
- Construcción de alertas y paneles junto al equipo, para monitorear y mantener la app disponible para el cliente.
2021 – 2024
Site Reliability Engineer — nivel M
iti — banco digital de Itaú · São Paulo, Brasil
2021 – 2024
Site Reliability Engineer — nivel M
iti — banco digital de Itaú · São Paulo, Brasil
- Orquestación de incidentes, soporte de canales y conducción de las ceremonias de post-mortem.
- Cultura de SLOs y observabilidad proactiva; instrumentación de microservicios .NET Core y Kotlin.
- Soporte de cientos de microservicios en Kubernetes/AWS EKS, con Splunk, Grafana, AppDynamics, Jaeger, Loki y Elasticsearch.
- Guardia on-call, eliminación de toil mediante automatización y pruebas de rendimiento con JMeter.
2020 – 2021
Site Reliability Engineer — nivel J
Stone Pagamentos · São Paulo, Brasil
2020 – 2021
Site Reliability Engineer — nivel J
Stone Pagamentos · São Paulo, Brasil
- Equipo de operaciones e infraestructura responsable del ciclo de vida de un conjunto de servicios: despliegue, disponibilidad, rendimiento, cambios y emergencias.
- Capacity planning y automatización de infraestructura como código en Google Cloud.
- Interlocución con los equipos de desarrollo y con gobernanza, garantizando la adherencia a estándares y compliance.
formación
- Ingeniería de Producción — INATEL · 2021–2025
- Project Management — Ohio University · 2025
- Business English — Ohio University · 2025
stack y herramientas
- Grafana
- Prometheus
- Loki
- OpenTelemetry
- Datadog
- Zabbix
- AWS EKS
- Azure
- Kubernetes
- Terraform
# proyectos
Mis proyectos
# charlas
Charlas y presentaciones
Agilidad en la práctica
HackMundo
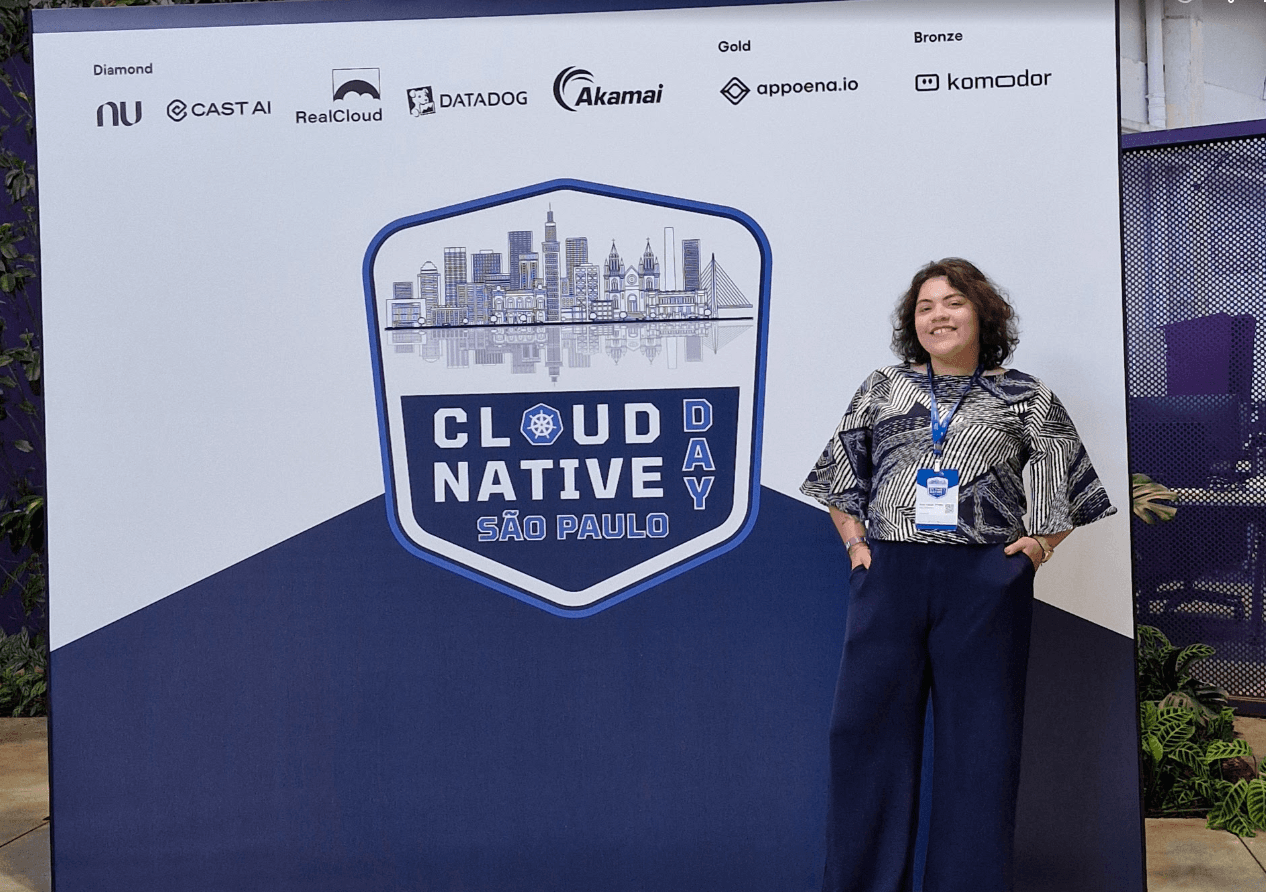
Del Prometheus al GPT: una nueva era en la observabilidad inteligente
Cloud Native Day São Paulo · São Paulo, Brasil
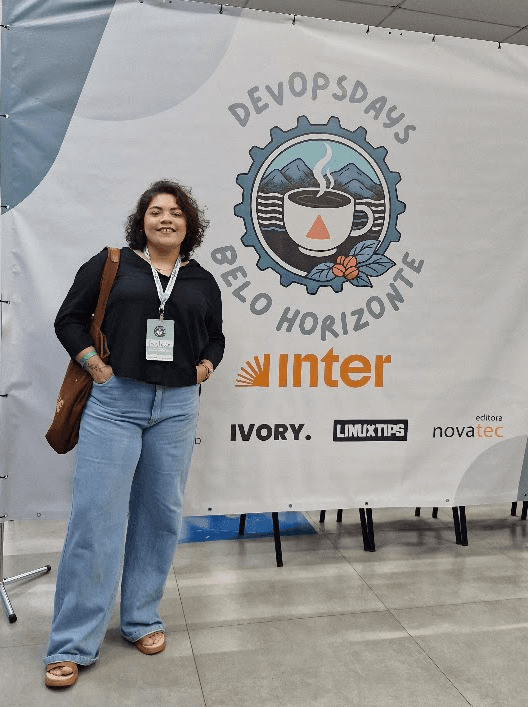
Las soft skills que un devops necesita y nadie te cuenta
DevOps Days Belo Horizonte · Belo Horizonte, Brasil
Taller de emprendimiento
HackMundo
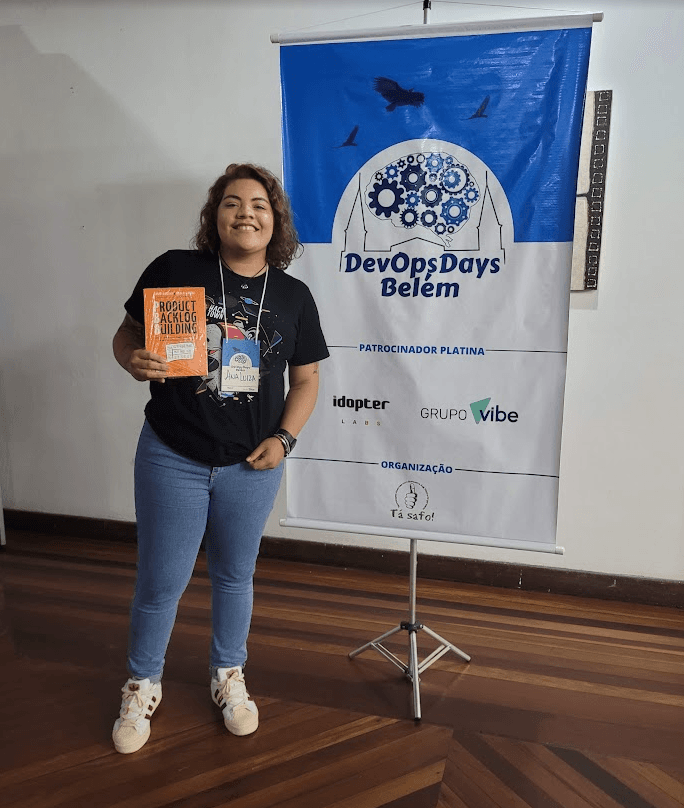
Build and Run
DevOps Days Belém · Belém, Brasil